多就是好吗?
上周末刷朋友圈,看到一位很多年前共事过的前同事发了一条动态,配了一张后台用量截图,文字大意是感慨自己「一天就烧了将近 2 亿 token」。
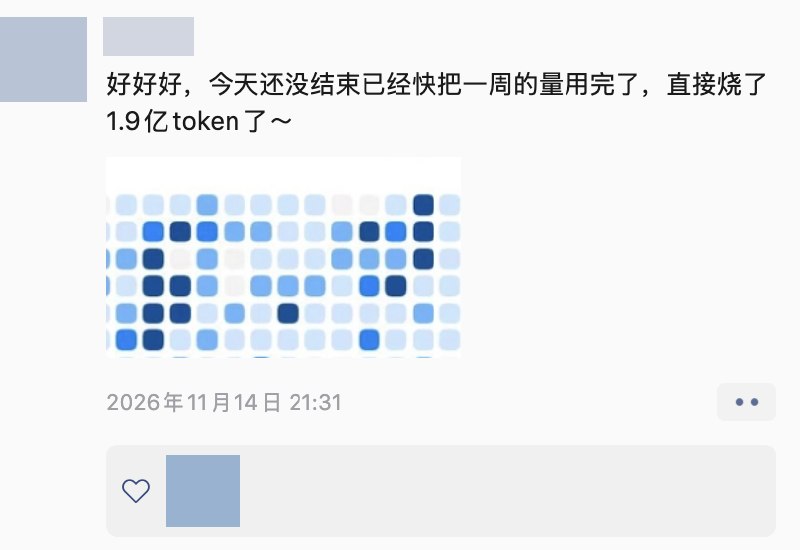
如果这话是从一个天天折腾 Agent 或者写代码的程序员嘴里说出来,大家早就见怪不怪了。让我稍微停顿了一下的是她的背景。她是一名年纪不算轻的销售,以前我们共事的时候,她做的是非常传统的销售业务,跟技术、互联网甚至数码产品都隔着挺远的距离。一个传统行业的从业者,到了这个阶段还能主动去拥抱新工具,并且真的高频用起来,单看这个转变本身,绝对是件让人佩服的好事。
不过划过去之后,我脑子里冒出来另一个问题:token 烧得多,就代表用得好吗?
现在社交网络上好像有一种新的炫耀方式,或者说新的勤奋证明。以前大家晒加班到凌晨的打车软件截图,晒密密麻麻的读书笔记,现在变成了晒 API 账单、晒 token 消耗量。仿佛那个数字越庞大,就越能证明自己站在了时代的浪潮尖上,越能说明自己生产力爆棚。
往深了想,这种逻辑其实挺经不起推敲的。就像一个人的梳妆台上摆满了上百瓶化妆品,不代表她就懂得什么是适合自己的美;一个学生的书桌抽屉里塞满了各种限定款式的荧光笔和手账本,也不代表他就能考出好成绩。我们太容易把「占有资源」和「消耗资源」的过程,直接等同于「产出结果」本身了。
我自己深度使用 AI 工具和大模型这一年多,最大的体会恰恰相反。往往是我对一个问题完全没有头绪、甚至连自己到底想要什么都讲不清楚的时候,token 掉得最快。因为那个时候人在偷懒,把本该自己完成的思考和筛选工作,全盘推给了模型。你丢过去一堆未经整理的背景资料,给一个含糊不清的指令,让它生成一万字,看着不对劲,再让它改一万字。几个来回下来,几百万 token 没了,账单看着挺吓人,实际上只是在制造高密度的数字垃圾。
反过来,当我想清楚了边界,知道哪一步该由我来做判断、哪一步该让工具去执行时,消耗反而会降下来。我会先把杂乱的信息在脑子里过一遍,抽取出核心的矛盾,再用几句准确的话喂给它。这时候人和工具的关系是清爽的,我是那个拿主意的人,它只是帮我省去机械劳动的帮手。
为什么很多人会迷恋「2 亿 token」这种数字?说到底,是因为衡量「真实产出」太难了,而衡量「消耗了多少」太容易了。后台面板上跳动的数字会给人一种即时的多巴胺反馈,让你觉得自己今天特别充实,干了一票大的。至于这 2 亿 token 最终转化成了多少有效的客户跟进、解决了几个实际的业务卡点、或者帮自己省下了多少真正可以拿去休息的时间,很多人是不去算这笔细账的。
这跟职场里常见的低质量勤奋如出一辙。有些人开会一定要拉上十几个人的群,文档一写就是几十页,周报里贴满了各种数据图表,看起来热闹极了,消耗了团队大量的注意力。可一旦你追问一句「所以你的结论是什么,下一步谁来负责」,对方往往就卡壳了。没有主见的勤奋,加上放大效率的工具,很多时候只是在加速制造噪音。
我从来不觉得工具用得多、参数调得猛有什么值得焦虑或者羡慕的。工具始终是工具,它的上限取决于使用它的人有没有清晰的意图和审美。如果一个人本身缺乏对问题的拆解能力,缺乏做取舍的魄力,给他再大的上下文窗口、再不设限的额度,也只是把原本手工作坊式的混乱,升级成了工业化规模的混乱。
这几天我也在审视自己手头的工作流。以前看到别人分享那种极度复杂的自动化流,动辄串起七八个模型、跑上百个节点,我也会心痒,想去搭一个试试。现在我越来越倾向于做减法。每次打开对话框或者调整脚本之前,我会先停下来问自己一句:这件事的核心判断我做完了吗?如果我自己还没想明白,那就先合上电脑去散个步,而不是急着敲下回车,去烧那几百万个毫无意义的 token。
少一点用数字自我感动的时刻,盯紧那个最终需要你签字负责的结果,这大概才是和工具相处最省心的方式。